为什么深入理解 AI 架构的工程师必须掌握这张图
为什么深入理解 AI 架构的工程师必须掌握这张图
算子背后的几何骨架
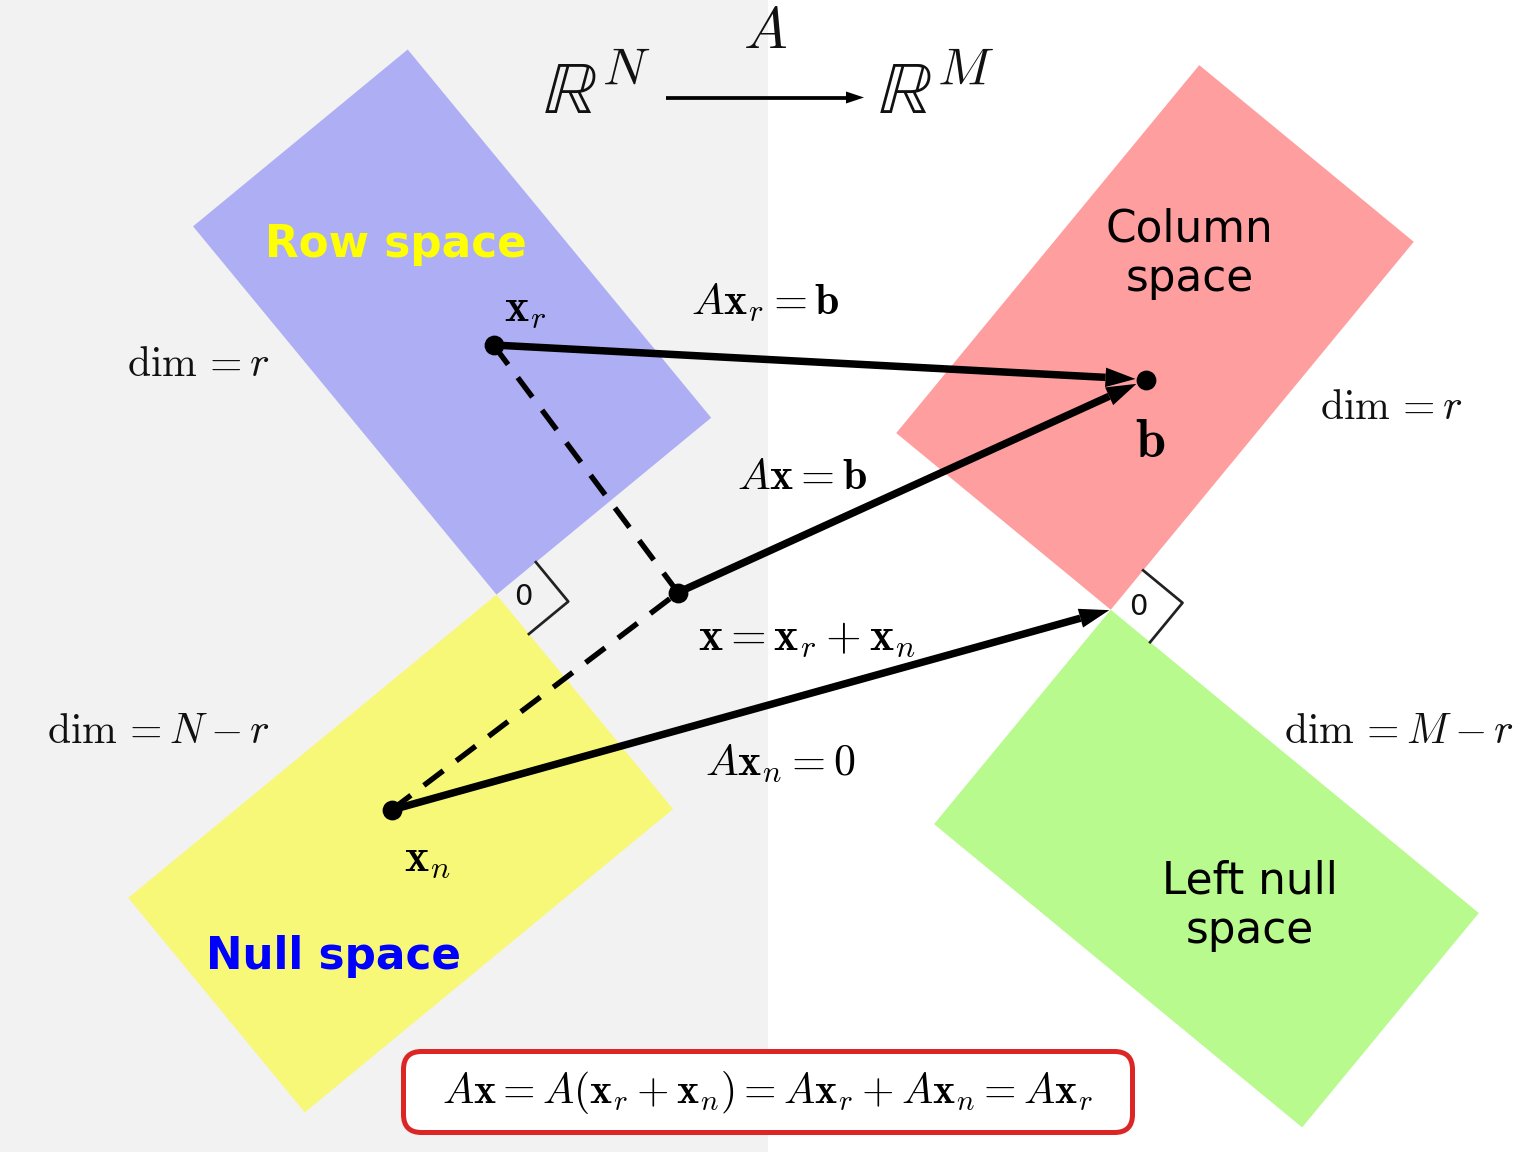
今天在整理《Mathematics for AI & ML》第三章“子空间与正交性”时,我重新画了我的线性代数老师——MIT 斯特朗教授(Gilbert Strang)那个著名的经典大图景(The Big Picture):矩阵 $A$ 在四个基本子空间上的作用。
画这张图的时候,很多记忆一下子涌了上来。
其实大学二年级时我就学过线性代数,靠死记硬背特征值和行列式考了九十二分,但脑子里全是一堆没有来由的公式。我现在对“行列式”这个词还一直耿耿于怀——“行列”为啥不叫矩阵,“式”感觉像公式或者样式,但它其实是个数值。
我就这样带着懵懂进了门。后来在 MIT 坐在斯特朗教授的课堂里,听他用完全不同的视角拆解空间。我当时听他讲“四大基本子空间”,觉得很神奇,但心里也在犯嘀咕:这到底有啥用呢?而且我们大学的教材上根本连提都没提过。
他讲话不疾不徐,声音很稳。讲到关键推导时,常常会停下来,两手抱在胸前驻足思考,然后转过身问我们一句:“Why?” 课间休息时我找他请教一道代数问题的几何解释,他微笑着在黑板上慢慢画了几笔,我一下子就全懂了。
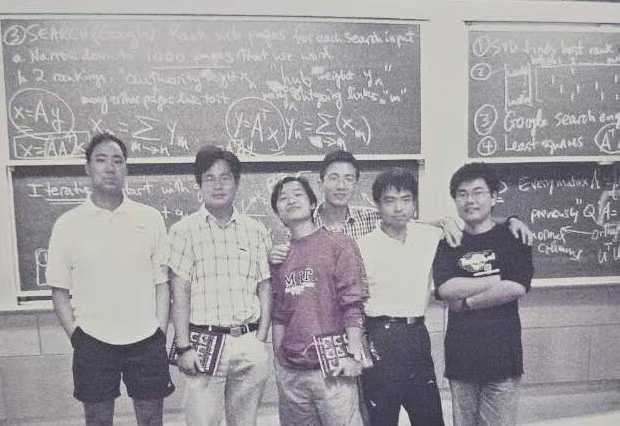
那扇门由此向我打开。数学不再是一堆干瘪的公式,而是一种描述空间结构与变换的语言。
后来我才知道,原来斯特朗教授是第一个把“四个基本子空间”系统性引入大学线性代数教学的人。哇,原来我当年是那么幸运!
再后来我自己写《Mathematics for AI & ML》,在很大程度上也是想追随老师的脚步,把这种直观的几何底色传递给更多人。
很多刚入行的工程师可能会觉得,现代 AI 不就是矩阵乘法和调包吗?写个 y = model(x),调个 PyTorch 的 nn.Linear,求导有自动微分,训练有 AdamW,何必去深究这些维数定理、正交补和零空间?——就跟我当年坐在 MIT 教室里犯嘀咕一样:这东西到底有啥用?
但当大模型在特定任务上坍缩、当微调破坏了底模通用能力、当对抗样本以人眼不可见的噪声击穿视觉模型、或者当你想弄明白为什么 70B 参数的模型只用秩为 8 的 LoRA 就能学会新任务时——代码给不了你解释。
答案全在老师当年画给我们的这张图里。
读懂这张大图景
在数学上,给定一个实矩阵 $A \in \mathbb{R}^{M \times N}$(它代表了神经网络中任意一个线性映射层),整个空间被完全分解为四块积木:
1. 输入空间 $\mathbb{R}^N$:有效分量与沉默盲区
输入空间被严格剖分为两个互为正交补的子空间:
- 行空间(Row space)$C(A^\top)$:维数为秩 $r$。这是输入空间中真正能够引发输出响应的“有效输入方向”。
- 零空间(Null space)$N(A)$:维数为 $N - r$。所有落入这里的输入向量,经过 $A$ 的变换后都会被无情抹平为零向量 $\mathbf{0}$。
根据正交直和分解,空间中任何输入向量 $\mathbf{x} \in \mathbb{R}^N$ 都可以唯一且干净地拆解为:
2. 输出空间 $\mathbb{R}^M$:可达领域与不可逾越之墙
输出空间同样被分解为两个正交互补的部分:
- 列空间(Column space)$C(A)$:维数为 $r$。这是矩阵 $A$ 倾尽全力所能触达的全部世界(Reachable output)。
- 左零空间(Left null space)$N(A^\top)$:维数为 $M - r$。这是 $A$ 永远无法抵达的死角(Never reached),代表了系统拟合不了的残差与固有误差。
3. $A$ 的真正动作
当矩阵 $A$ 作用于任意输入 $\mathbf{x}$ 时,奇迹发生了:
$A$ 是一台极其纯粹的信息过滤器:
它把零空间里的噪音 $\mathbf{x}_n$ 彻底消解,同时将行空间里的特征 $\mathbf{x}_r$ 一对一(one-to-one)且满射地映射到列空间中的目标点 $\mathbf{b}$。
连接现代 AI 架构的五大几何洞察
一旦看懂了这四个基本子空间的正交结构,现代深度学习和前沿架构中许多看似神秘的经验直觉,便能在几何层面找到清晰的理论映射。
一、LoRA:低秩适配算子的零空间保护
在主流开源大语言模型(如 LLaMA、Qwen)中,注意力与前馈层的权重矩阵维度极其庞大(例如 $d = 4096$ 或 $8192$)。全量微调更新矩阵 $\Delta W \in \mathbb{R}^{d \times d}$ 意味着数以亿计的参数开销。
LoRA(Low-Rank Adaptation)假设特定下游任务的“内在维度”(Intrinsic Rank)非常低,将更新显式约束为低秩分解算子:
从斯特朗教授的子空间视角审视这个线性更新算子 $\Delta W$:
- 行空间 $C((\Delta W)^\top) = C(A^\top)$:维数至多为 $r$(比如 $r=8$ 或 $16$)。这意味着该层只有投影在狭窄行空间上的输入特征 $\mathbf{x}_r$,才会激发增量响应 $\Delta W \mathbf{x}_r = B(A\mathbf{x}_r)$。
- 代数零空间 $N(\Delta W) = N(A)$:维数高达 $d - r$。对于输入表示空间中绝大多数与行空间正交的方向 $\mathbf{x}_n \in N(A)$,适配器算子输出严格为零:$\Delta W \mathbf{x}_n = \mathbf{0}$。
- 在这些高维零空间方向上,全模型输出保持为 $W_{\text{new}}\mathbf{x}_n = (W_0 + \Delta W)\mathbf{x}_n = W_0\mathbf{x}_n$,完全由底模原生表征主导。这在几何上解释了为什么低秩适配能够在重塑特定任务行为的同时,对模型原有表征空间保持高度克制。
二、过参数化下的泛化奇迹:梯度流的隐式正则化
经典统计学常提醒我们:如果模型参数量远大于数据样本量($N \gg M$),系统极易发生严重过拟合。
无论是在经典视觉网络(数千万参数对百万张图片),还是大模型的全量指令微调中,参数自由度往往远超有效样本约束。按传统观点,模型的容量大到足以强行“背下”所有数据,为什么一阶优化依然能展现出优秀的泛化性能?
深度学习理论(如神经正切核 NTK 与过参数化回归)从子空间给出了深刻解答:
- 考虑模型在 $M$ 个训练样本上的输出预测向量 $\mathbf{f}(\mathbf{w}) \in \mathbb{R}^M$。该预测关于 $N$ 个参数的 Jacobian 矩阵 $J(\mathbf{w}) \in \mathbb{R}^{M \times N}$(其中 $J_{ij} = \frac{\partial f(\mathbf{x}_i; \mathbf{w})}{\partial w_j}$)是一个极度扁平的宽矩阵,其参数零空间维度极大:$\dim(N(J)) = N - M \gg 0$。
- 根据链式法则,经验损失关于参数的梯度严格位于当前 Jacobian 的行空间中:$\nabla_{\mathbf{w}} \mathcal{L} = J(\mathbf{w})^\top \mathbf{e} \in C(J(\mathbf{w})^\top)$。
- 在线性模型或过参数化超宽网络的“懒惰训练”(Lazy Training)极限下,$J(\mathbf{w}) \approx J_0$ 在训练中近似保持恒定。若以近零初始值启动纯梯度下降(GD),参数增量累积方向将始终被局限在固定的行空间 $C(J_0^\top)$ 内,而永远不会主动涉足无约束的零空间 $N(J_0)$。
- 此时梯度流天然收敛到无数个无误差解中的最小欧氏范数解(Minimum-Norm Solution):
- 虽然真实的非线性网络与自适应优化器(如 AdamW 的坐标缩放和权重衰减)打破了严格的欧氏子空间不变性,但这种沿着数据梯度张成的行空间更新、避免在盲目零空间中释放无用能量的几何偏置,正是现代深度网络天然具备抗噪与泛化能力的理论基石。
三、对抗攻防:高维空间中的能量耗散与精准刺击
为什么一张毫无异样的图片,仅仅叠加上一层微小扰动 $\boldsymbol{\delta}$,就能诱导分类器发生灾难性误判?而模型平时对各种随机噪点却表现得相当鲁棒?
高维子空间的正交分解揭示了这两种截然不同的几何命运:
- 随机噪声的方差耗散:设输入维度为 $D$(如高分辨率图像的百万像素),而分类敏感特征仅集中在一个极低维的有效子空间(维数为 $r \ll D$)。若注入各向同性的随机高斯白噪声 $\boldsymbol{\delta}$,根据高维几何,噪声能量在各个正交维度上均匀分布。落在敏感子空间上的期望能量占比仅约为 $\frac{r}{D} \ll 1$,绝大部分噪声能量都投影在了无害的正交补空间中。这就是高维模型天然耐受随机噪声的几何原因。
- 对抗扰动的无损定向:反向传播攻击算法(如 FGSM:$\boldsymbol{\delta} = \epsilon \operatorname{sign}(\nabla_{\mathbf{x}} \mathcal{L})$)正是利用端到端损失关于输入像素的梯度 $\nabla_{\mathbf{x}} \mathcal{L}$。它完全避开了漫无目的的随机扩散,将极其有限的扰动范数精准校准在与判别边界垂直的敏感梯度方向上,几乎不浪费任何能量在无关子空间中,从而以极小代价值穿分类器的决策平面。
四、残差与投影:左零空间的几何基石
如果说前几个支柱聚焦于输入侧的行空间与零空间,那么输出空间的左零空间 $N(X^\top)$,则是理解机器学习中所有线性投影与误差分解的母体。
在经典的线性最小二乘问题 $X\mathbf{w} \approx \mathbf{y}$ 中:
- 无论如何调整参数 $\mathbf{w}$,模型的预测输出 $\hat{\mathbf{y}} = X\mathbf{w}$ 永远受限在特征矩阵的列空间 $C(X)$ 内。
- 目标向量 $\mathbf{y}$ 到列空间的最优 $L_2$ 近似,必然是其正交投影 $\hat{\mathbf{y}} = P_{C(X)}\mathbf{y}$。此时观测残差:
恰好垂直掉落在与列空间正交互补的左零空间 $N(X^\top)$ 中。
- 著名的正规方程 $(X^\top X)\mathbf{w} = X^\top \mathbf{y}$,其本质就是极简的几何正交条件:残差向量与所有特征列正交($X^\top \mathbf{e} = \mathbf{0}$)。从回归、主成分分析(PCA)到卡尔曼滤波,整个经典估计理论的骨架,全由此正交互补性奠定。
五、生成模型:从线性子空间到流形切平面的几何升华
在现代生成式大模型中,从连续时间扩散模型(Diffusion Models)到流匹配(Flow Matching),这一几何思想从全局的线性子空间,自然跃升为局部的微分几何。
流形假设指出:高维像素空间 $\mathbb{R}^D$ 中的真实自然数据,高度聚集在一个维度极低的非线性流形 $\mathcal{M}$ 上。
- 当向图像不断注入噪声时,高维高斯云雾逐渐掩盖了流形结构。
- 降噪网络学习的得分函数(Score Function $\nabla_{\mathbf{x}_t} \log p_t(\mathbf{x}_t)$)与 Tweedie 公式,在局部几何上发挥着把带噪状态向低维数据流形拉回的引导作用。
- 虽然非线性流形的切空间(Tangent Space $T_{\mathbf{x}}\mathcal{M}$)与法向空间(Normal Space)是逐点旋转变化的,但这正是斯特朗教授“正交直和分解”在非线性世界里的生动回响:
- 切向空间承载着图像真实的语义流动与有效变化;
- 法向空间则承载着脱离流形的各向同性纯噪声。
- 整个反向生成过程,本质上就是在微积分的每一步中,不断将法向偏离流形的噪声剥离冲洗干净,让轨迹沿着流形切向收敛,最终还原出高保真的晶莹世界。
结语
在现代工业化 AI 开发中,调包和搭积木很容易让人产生一种错觉,以为算法只是算力的堆叠。
但真正决定一个架构能否走得通、能否收敛、能否抵抗扰动、能否高效微调的,从来不是黑盒表象,而是底层的空间投影与正交约束。
矩阵不是数字表格,它是空间的扭转与过滤。当年斯特朗教授在黑板前抱臂问的那句“Why”,追问的正是这层底层的几何理由。
当你下一次看着 Transformer 层的权重热力图、看着 LoRA 的低秩适配器、或者推导扩散模型的损失方程时,不妨在脑海里浮现出这四个互相垂直的子空间:
行聚精微见性真,
零消冗浊寂无尘。
列开万象穷所至,
左度残差一念深。
弄懂了老师的这张图,AI 模型的黑盒就在你眼前变成透明的了。